PDFs richtig schwärzen: Warum ein schwarzer Balken nicht reicht!
Warum schwarze Balken in PDFs Daten nicht zwingend entfernen und wie sich versteckte Inhalte vor der Veröffentlichung prüfen lassen
Dieser Artikel hat eine Lesedauer von 8 Minuten.
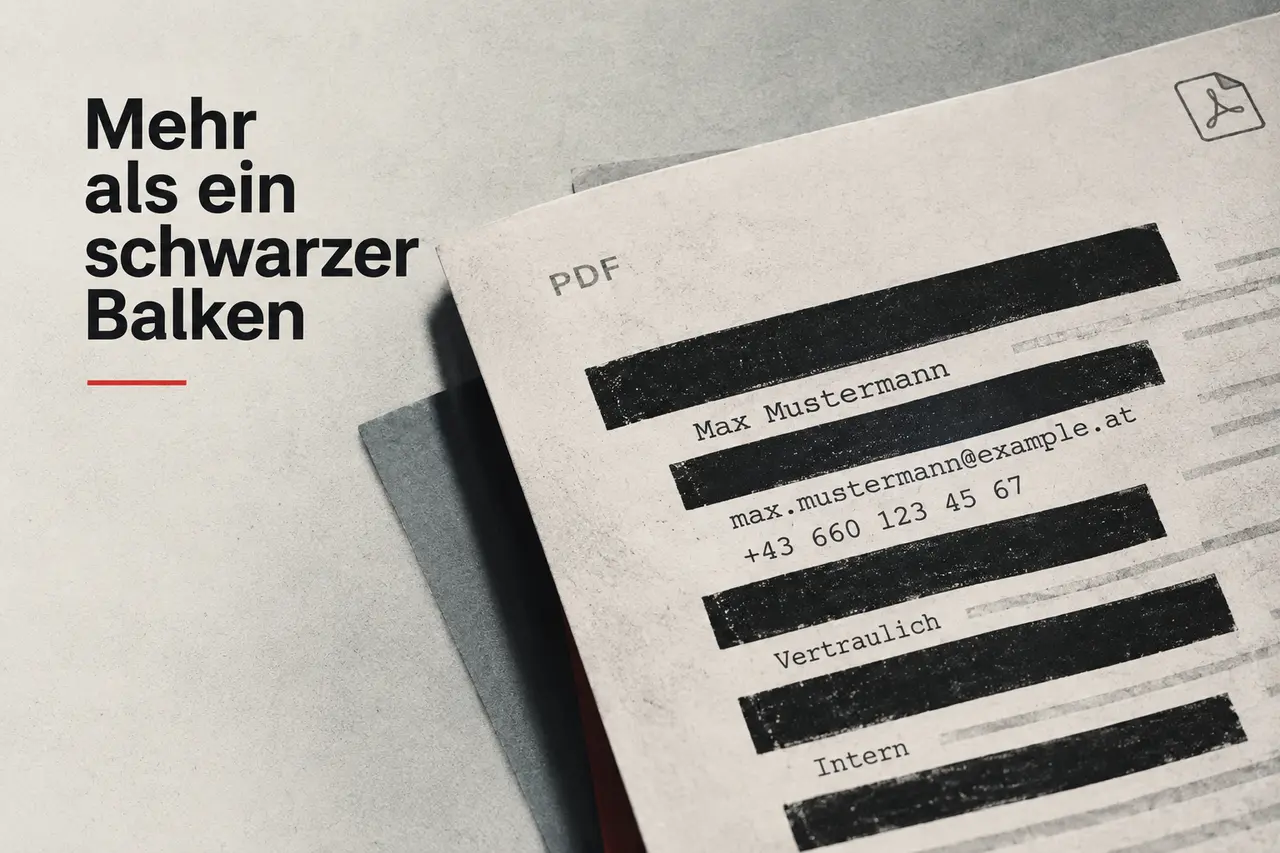
Ein PDF kann im Viewer sauber geschwärzt aussehen und trotzdem den ursprünglichen Text enthalten. Entscheidend ist nicht die Optik, sondern was nach Export und Verarbeitung technisch noch in der Datei steckt.
Ein PDF ist keine Seite Papier
Auf Papier ist eine Schwärzung vergleichsweise einfach zu verstehen. Eine Information wird physisch verdeckt und ist danach im besten Fall nicht mehr lesbar.
Bei einer PDF funktioniert dieses mentale Modell nicht besonders gut.
Eine PDF beschreibt eine Seite aus verschiedenen Objekten. Dazu können Texte, Bilder, Vektorgrafiken, Formulare, Kommentare und weitere Elemente gehören. Entscheidend ist dabei auch die Reihenfolge, in der diese Objekte dargestellt werden.
Vereinfacht kann eine Seite technisch so aufgebaut sein:
1. Text "Max Mustermann"
2. schwarzes Rechteck über diesem Text
Der PDF-Viewer zeichnet zuerst den Text und danach das Rechteck. Für den Menschen sieht das Ergebnis geschwärzt aus.
Der ursprüngliche Text kann trotzdem weiterhin vollständig in der Datei vorhanden sein.
Genau darin liegt einer der häufigsten Fehler beim Schwärzen von PDFs: Eine Information wird optisch versteckt, aber technisch nicht entfernt.
Überdecken ist nicht dasselbe wie Entfernen
Für eine Recherche habe ich 4.957 öffentlich verfügbare Behörden-PDFs aus Deutschland und Österreich untersucht.
Die technische Untersuchung habe ich mit der Software RedactionResearch durchgeführt.
Dabei fanden sich im deutschen Datensatz mehrere Dokumente, bei denen vermeintlich geschwärzte Informationen technisch weiterhin zugänglich waren. In einzelnen Fällen ließen sich Namen, Adressen, E-Mail-Adressen und Telefonnummern rekonstruieren. Bei einer Behörde waren sogar 83 geschwärzte Textpassagen wiederherstellbar.
Das Interessante daran ist weniger ein einzelner Softwarefehler. Das eigentliche Problem liegt im Verarbeitungsprozess.
Wenn ein Programm lediglich ein schwarzes Rechteck über einen Text legt, existieren anschließend zwei Objekte:
Text
+
schwarze Fläche
Ein Programm zur Textextraktion interessiert sich nicht zwingend dafür, welches Objekt im Viewer darüberliegt. Es kann den Text direkt aus der internen Struktur der PDF lesen.
Aus Sicht von Privacy ist deshalb nicht entscheidend, ob eine Information auf dem Bildschirm sichtbar ist. Entscheidend ist, ob sie überhaupt noch in der veröffentlichten Datei existiert.
Der einfachste Test ist Textextraktion
Für einen ersten technischen Check braucht es keine komplexe Forensik.
Unter macOS lassen sich beispielsweise die Poppler-Werkzeuge über Homebrew installieren:
brew install popplerDanach kann der Text einer PDF mit pdftotext extrahiert werden:
pdftotext dokument.pdf -Alternativ lässt sich das Ergebnis komfortabler durchsuchen:
pdftotext dokument.pdf - | lessKennt man einen Begriff, der eigentlich entfernt worden sein sollte, kann man gezielt danach suchen:
pdftotext dokument.pdf - | grep -i "Mustermann"Taucht ein geschwärzter Name hier weiterhin auf, ist die Schwärzung offensichtlich nicht ausreichend.
Wichtig ist allerdings auch die umgekehrte Richtung: Nur weil pdftotext nichts findet, ist damit noch nicht bewiesen, dass die Datei frei von problematischen Informationen ist.
Textextraktion ist ein Test, kein vollständiges Prüfverfahren.
OCR erzeugt eine zweite Ebene
Besonders interessant werden gescannte Dokumente.
Ein Scan besteht zunächst nur aus Bildern. Damit der Inhalt trotzdem durchsucht werden kann, verwenden viele Systeme OCR, also Optical Character Recognition.
Dabei kann zusätzlich zum sichtbaren Seitenbild eine unsichtbare Textebene entstehen.
Die PDF enthält dann vereinfacht:
sichtbares Seitenbild
+
unsichtbaren erkannten Text
Werkzeuge wie OCRmyPDF können genau solche durchsuchbaren PDFs erzeugen.
Das ist im Alltag äußerst praktisch. Für Schwärzungen bedeutet es allerdings, dass mehrere Ebenen berücksichtigt werden müssen.
Eine Information kann im sichtbaren Dokument verschwunden sein und trotzdem noch an anderer Stelle innerhalb der Datei existieren.
Deshalb sollte immer die tatsächlich veröffentlichte Datei getestet werden und nicht lediglich die Version, die unmittelbar im Bearbeitungsprogramm geöffnet ist.
Metadaten sind ebenfalls Teil der Datei
Neben dem eigentlichen Seiteninhalt können PDFs zahlreiche Metadaten enthalten.
Dazu gehören beispielsweise Felder wie:
Creator
Producer
Author
CreationDate
ModifyDate
Ein schneller Überblick ist mit pdfinfo möglich:
pdfinfo dokument.pdfFür eine ausführlichere Analyse kann beispielsweise ExifTool verwendet werden:
brew install exiftoolDanach:
exiftool dokument.pdfIn unserer Untersuchung fanden sich sogar E-Mail-Adressen in PDF-Metadaten, die im sichtbaren Dokument selbst nicht vorhanden waren.
Die Metadaten haben allerdings noch eine zweite Besonderheit.
Sie erzählen nicht zuverlässig, mit welchem Programm eine Behörde ein Dokument ursprünglich erstellt oder geschwärzt hat.
Eine PDF kann mehrere Stationen durchlaufen:
Textverarbeitung
→ PDF-Export
→ Upload
→ Konvertierung
→ OCR
→ Optimierung
→ Veröffentlichung
Jeder dieser Schritte kann Metadaten verändern.
In unserem Datensatz fanden wir beispielsweise im deutschen Korpus 332 unterschiedliche Kombinationen der Felder "Producer" und "Creator", im österreichischen lediglich sieben.
Das bedeutet nicht, dass 332 verschiedene Programme für die Schwärzungen verantwortlich waren.
Metadaten sind besser als Spuren der bisherigen Verarbeitungskette zu verstehen.
Auch Anhänge und Kommentare gehören zum Check
PDF ist ein Containerformat. Neben den sichtbaren Seiten kann eine Datei weitere Inhalte enthalten.
Dazu gehören beispielsweise:
- Dateianhänge
- Kommentare
- Formularinformationen
- zusätzliche Metadaten
- unsichtbare Textebenen
Mit Poppler lässt sich beispielsweise prüfen, ob Dateien eingebettet sind:
pdfdetach -list dokument.pdfAuch Kommentare und Formularinhalte sollten vor einer Veröffentlichung kontrolliert werden.
Gerade bei Dokumenten, die mehrfach zwischen verschiedenen Programmen ausgetauscht wurden, lohnt sich dieser Blick.
Kopieren ist ein nützlicher Schnelltest
Ein erstaunlich einfacher Test besteht darin, den Bereich um eine Schwärzung im PDF-Viewer zu markieren und den Inhalt in einen Texteditor zu kopieren.
Wenn dort plötzlich der vermeintlich entfernte Text erscheint, ist das Problem offensichtlich.
Dieser Test ist allerdings ebenfalls nur eine erste Kontrolle.
Nicht jeder versteckte Inhalt lässt sich über die Zwischenablage erreichen. Unterschiedliche PDF-Viewer interpretieren Dateien außerdem nicht immer identisch.
Gerade deshalb sollte die finale Datei zusätzlich in einem anderen Programm geöffnet werden.
Warum ein Screenshot nicht das eigentliche Problem löst
Eine häufige Reaktion auf solche Fälle lautet: Dann speichert man eben jede Seite als Bild.
Das kann bestimmte Klassen versteckter Textinformationen tatsächlich beseitigen, ist aber kein besonders eleganter Standardprozess.
Dabei gehen unter anderem Eigenschaften wie durchsuchbarer Text, Barrierefreiheit und teilweise auch die Qualität des Dokuments verloren.
Vor allem ersetzt dieser Ansatz keinen kontrollierten Freigabeprozess.
Ein sinnvolleres Ziel ist, die zu entfernenden Informationen tatsächlich aus dem Dokument zu löschen und anschließend zu überprüfen, ob das Ergebnis technisch dem entspricht, was im Viewer zu sehen ist.
Der finale Download zählt
Bei unserer Recherche zeigte sich noch ein weiterer wichtiger Punkt: Die öffentlich abrufbare PDF muss technisch nicht identisch mit der Datei sein, die ursprünglich hochgeladen wurde.
Veröffentlichungsplattformen können PDFs beispielsweise konvertieren, optimieren oder mit OCR bearbeiten.
Dadurch können sich sowohl die interne Struktur als auch die Metadaten verändern.
Für einen belastbaren Test reicht es deshalb nicht, nur die lokale Datei vor dem Upload zu kontrollieren.
Geprüft werden sollte auch die Version, die später tatsächlich öffentlich heruntergeladen werden kann.
Ein sinnvoller Ablauf sieht beispielsweise so aus:
Original
→ Schwärzung
→ Export
→ lokale Prüfung
→ Upload
→ Verarbeitung durch die Plattform
→ Download der veröffentlichten Datei
→ erneute Prüfung
Gerade bei automatisierten Veröffentlichungsprozessen ist dieser letzte Schritt leicht zu übersehen.
Ein pragmatischer Prüfablauf
Für normale Veröffentlichungen muss daraus keine komplexe PDF-Forensik werden.
Ein reproduzierbarer Prozess ist wichtiger als eine lange Werkzeugliste.
Ich würde mindestens folgende Schritte einplanen:
- Informationen mit einer echten Schwärzungsfunktion entfernen und nicht nur optisch überdecken.
- Die fertige Datei neu speichern oder exportieren.
- Den vollständigen Text aus der exportierten PDF extrahieren.
- Nach Begriffen suchen, die entfernt worden sein sollten.
- Metadaten kontrollieren.
- Anhänge, Kommentare und andere zusätzliche Inhalte prüfen.
- Die Datei in einem zweiten PDF-Viewer öffnen.
- Bei einer Web-Veröffentlichung die veröffentlichte Version erneut herunterladen und prüfen.
Wer ohnehin viel im Terminal arbeitet, kann einen Teil davon leicht automatisieren.
Ein sehr einfacher Check könnte beispielsweise so aussehen:
pdftotext freigabe.pdf - > /tmp/pdf-text.txt
pdfinfo freigabe.pdf
pdfdetach -list freigabe.pdf
Danach können bekannte sensible Begriffe gesucht werden:
grep -iE "Mustermann|example@example.com|01234" /tmp/pdf-text.txtDas ersetzt keine umfassende Prüfung, reduziert aber die Wahrscheinlichkeit, dass eine rein optische Schwärzung unbemerkt veröffentlicht wird.
Nicht das Programm ist entscheidend
Nach einem fehlerhaft geschwärzten Dokument liegt die Suche nach dem verantwortlichen Programm nahe.
In der Praxis ist diese Zuordnung oft deutlich schwieriger.
Eine Datei kann mit einem Programm erstellt, mit einem zweiten exportiert, von einer Plattform konvertiert und anschließend von einem weiteren Werkzeug per OCR verarbeitet worden sein.
Am Ende steht im Metadatenfeld möglicherweise das letzte Programm der Kette.
Das eigentliche Schwärzen kann mehrere Schritte vorher stattgefunden haben.
Deshalb halte ich es für sinnvoller, nicht primär auf bestimmte Programme zu vertrauen oder einzelne Tools pauschal verantwortlich zu machen.
Entscheidend ist das Ergebnis.
Ist die Information noch vorhanden?
Kann sie extrahiert werden?
Taucht sie in Metadaten auf?
Existiert sie noch in einer anderen Ebene der Datei?
Und entspricht die öffentlich verfügbare Datei tatsächlich jener Version, die geprüft wurde?
Sicherheit entsteht durch einen überprüfbaren Prozess
Die wichtigste Erkenntnis aus knapp 5.000 untersuchten PDFs ist für mich deshalb keine spezielle Schwachstelle eines bestimmten Programms.
Es ist die Diskrepanz zwischen visueller und technischer Kontrolle.
Menschen öffnen eine PDF, sehen einen schwarzen Balken und interpretieren diesen als entfernte Information.
Ein Computer sieht dagegen Objekte, Textebenen, Metadaten und Anhänge.
Beides kann gleichzeitig stimmen: Der Text ist für den Menschen unsichtbar und für Software weiterhin problemlos lesbar.
Genau deshalb sollte eine Schwärzung nicht mit der Frage enden, ob das Dokument richtig aussieht.
Die bessere Frage lautet:
Ist die Information wirklich nicht mehr in der veröffentlichten Datei enthalten?
FAQ
Reicht ein schwarzer Balken aus, um Text in einer PDF zu schwärzen?
Nein. Wird Text nur mit einer schwarzen Fläche überdeckt, kann der ursprüngliche Inhalt weiterhin als Textobjekt in der PDF vorhanden und extrahierbar sein.
Wie kann ich prüfen, ob geschwärzter Text noch in einer PDF steckt?
Ein erster Test ist die Textextraktion mit Werkzeugen wie pdftotext. Zusätzlich sollten Metadaten, Anhänge, Kommentare und der finale Export kontrolliert werden.
Sind PDF-Metadaten ein zuverlässiger Hinweis auf das verwendete Programm?
Nur eingeschränkt. Creator- und Producer-Angaben können durch Export, OCR, Konvertierung oder Veröffentlichungsplattformen verändert werden.